업데이트 안내
2026년 동행복권 사이트 개편으로 기존 회차 조회 URL은 더 이상 JSON을 주지 않는다. 대신 /lt645/ 경로 아래의 새 JSON API를 쓰면 된다.
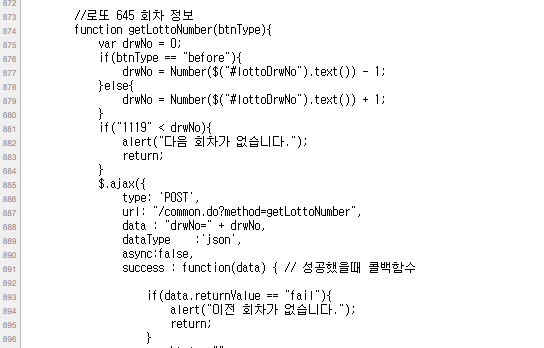
기존 URL https://www.dhlottery.co.kr/common.do?method=getLottoNumber&drwNo=1119를 호출하면 이제 동행복권 메인 페이지(HTML)로 리다이렉트된다. 그래서 기존 코드는 json.loads 단계에서 실패한다.
이 글은 새 API 주소, 바뀐 필드명, 기존 코드를 거의 그대로 살리는 호환 래퍼를 정리한 것이다. 아래 내용은 2026년 10월 기준으로 직접 호출해 확인했다.
새 엔드포인트
특정 회차는 selectPstLt645InfoNew.do, 최신 회차는 selectPstLt645Info.do로 가져온다. 둘 다 별도 인증 없이 application/json을 반환한다.
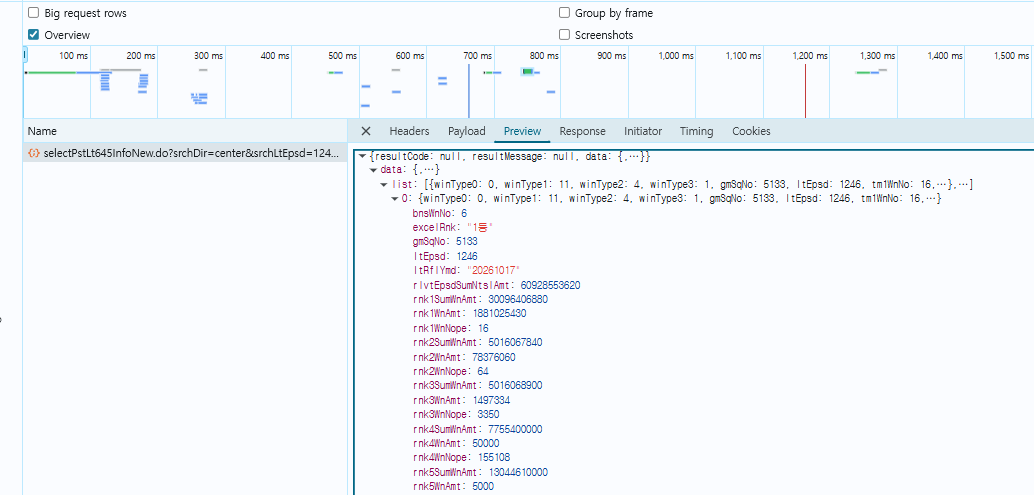
찾는 방법은 예전과 같다. 크롬 개발자도구(F12)의 Network 탭을 연다. 그 상태로 로또6/45 추첨결과 페이지에서 회차를 바꿔 보면, Fetch/XHR 목록에 아래 요청이 보인다.
| 용도 | URL | 비고 |
| 특정 회차 | https://www.dhlottery.co.kr/lt645/selectPstLt645InfoNew.do?srchDir=center&srchLtEpsd=1119 | 지정 회차를 중심으로 10개 회차를 반환 (1119 → 1114~1123) |
| 최신 회차 1건 | https://www.dhlottery.co.kr/lt645/selectPstLt645Info.do | 파라미터 없이 최신 회차 1건 반환 |
| 메인 요약 | https://www.dhlottery.co.kr/selectMainInfo.do | data.result.pstLtEpstInfo.lt645에 최근 5회. 순서가 섞여 있어 정렬 필요 |
srchLtEpsd가 회차 번호다. 예전 drwNo와 같은 역할이다.
selectPstLt645Info.do?srchLtEpsd=1119처럼 회차를 줘도 최신 회차만 돌아온다. 따라서 특정 회차는 InfoNew로 받아서 원하는 회차만 골라내야 한다.
참고로 selectPstLt645Info.do?srchLtEpsd=all로 전 회차를 받은 사례도 있다. 직접 검증하지는 못했으니 참고만 하자.
응답 JSON
응답은 data.list 배열에 회차별 객체가 들어 있는 구조다. 아래는 1119회 항목만 뽑아 주석을 단 것이다. 기존 글의 1119회 값과 정확히 일치한다.
{
   "resultCode": null,
   "resultMessage": null,
   "data": {
      "list": [
         {
            "ltEpsd": 1119,                    // 회차
            "ltRflYmd": "20240511",            // 추첨일 (YYYYMMDD)
            "tm1WnNo": 1,                      // 1번째 번호
            "tm2WnNo": 9,                      // 2번째 번호
            "tm3WnNo": 12,                     // 3번째 번호
            "tm4WnNo": 13,                     // 4번째 번호
            "tm5WnNo": 20,                     // 5번째 번호
            "tm6WnNo": 45,                     // 6번째 번호
            "bnsWnNo": 3,                      // 보너스 번호
            "rnk1WnNope": 19,                  // 1등 당첨자 수
            "rnk1WnAmt": 1396028764,           // 1등 1인당 당첨금
            "rnk1SumWnAmt": 26524546516,       // 1등 총 당첨금
            "rnk2WnNope": 97,                  // 2등 당첨자 수 (rnk2~5 동일 패턴)
            "rnk2WnAmt": 45574823,             // 2등 1인당 당첨금
            "rnk2SumWnAmt": 4420757831,        // 2등 총 당첨금
            "rnk3WnNope": 3108,
            "rnk3WnAmt": 1422381,
            "rnk3SumWnAmt": 4420760148,
            "rnk4WnNope": 155000,
            "rnk4WnAmt": 50000,
            "rnk4SumWnAmt": 7750000000,
            "rnk5WnNope": 2560859,
            "rnk5WnAmt": 5000,
            "rnk5SumWnAmt": 12804295000,
            "sumWnNope": 2719083,             // 1~5등 전체 당첨자 수
            "wholEpsdSumNtslAmt": 111840714000,// 총판매금액
            "rlvtEpsdSumNtslAmt": 55920357000, // 의미 미확인 (총판매금액의 약 절반)
            "winType1": 15,                    // 1등 자동 당첨 수
            "winType2": 4,                     // 1등 수동 당첨 수
            "winType3": 0,                     // 1등 반자동 당첨 수
            "winType0": 0,
            "gmSqNo": 5133,
            "excelRnk": "1등"
         }
         // ... 1114 ~ 1123회 항목이 함께 온다
      ]
   }
}
winType1~3은 결과 페이지의 "1등 자동/수동/반자동" 숫자와 일치한다. 1246회 기준 11/4/1이었다. winType0, gmSqNo, excelRnk는 의미를 확인하지 못했다.
기존 필드와 새 필드 비교
필드 이름은 모두 바뀌었다. 하지만 1:1로 대응되므로 매핑만 바꾸면 된다. 추첨일 형식과 성공 여부 판단 방식은 주의해야 한다.
| 기존 필드 | 새 필드 | 설명 |
| drwNo | ltEpsd | 회차 |
| drwNoDate (2024-05-11) | ltRflYmd (20240511) | 추첨일. 구분자 없는 형식으로 바뀜 |
| drwtNo1 ~ drwtNo6 | tm1WnNo ~ tm6WnNo | 당첨번호 6개 |
| bnusNo | bnsWnNo | 보너스 번호 |
| firstWinamnt | rnk1WnAmt | 1등 1인당 당첨금 |
| firstPrzwnerCo | rnk1WnNope | 1등 당첨자 수 |
| firstAccumamnt | rnk1SumWnAmt | 1등 총 당첨금 |
| totSellamnt | wholEpsdSumNtslAmt | 총판매금액 |
| returnValue | 없음 | list에 해당 ltEpsd가 있는지로 판단 |
| 없음 | rnk2~5WnNope / WnAmt / SumWnAmt | 2~5등 당첨자 수와 금액 (신규) |
| 없음 | winType1~3 | 1등 자동/수동/반자동 수 (신규) |
정정: 기존 글에서 totSellamnt를 "전체 당첨 상금 총액"이라고 설명했는데, 이는 잘못이다. 실제로는 총판매금액이다. 결과 페이지의 1246회 총판매금액 121,857,105,000원이 wholEpsdSumNtslAmt 값과 같다.
파이썬 예제: 기존 포맷 호환 래퍼
새 응답을 예전 키 이름으로 바꿔 주는 함수를 두면, 기존 코드는 호출 함수만 교체하면 된다. 반환값은 예전 getLottoNumber 응답과 같은 모양이다.
import requests

BASE = "https://www.dhlottery.co.kr/lt645"
HEADERS = {
    "User-Agent": "Mozilla/5.0",
    "Referer": "https://www.dhlottery.co.kr/lt645/result",
}


def _get_list(url, params=None):
    """API를 호출해 data.list 를 반환한다."""
    r = requests.get(url, params=params, headers=HEADERS, timeout=10)
    r.raise_for_status()
    # 차단/대기 시에는 HTML 페이지가 오므로 Content-Type 을 먼저 확인
    if "application/json" not in r.headers.get("Content-Type", ""):
        raise RuntimeError("JSON이 아닌 응답 (접속 대기/차단 페이지 가능성)")
    return r.json()["data"]["list"]


def to_legacy(it):
    """새 응답 항목을 예전 getLottoNumber 포맷으로 변환한다."""
    d = it["ltRflYmd"]  # "20240511"
    out = {
        "returnValue": "success",
        "drwNo": it["ltEpsd"],
        "drwNoDate": f"{d[:4]}-{d[4:6]}-{d[6:]}",
        "bnusNo": it["bnsWnNo"],
        "firstWinamnt": it["rnk1WnAmt"],
        "firstPrzwnerCo": it["rnk1WnNope"],
        "firstAccumamnt": it["rnk1SumWnAmt"],
        "totSellamnt": it["wholEpsdSumNtslAmt"],
    }
    for i in range(1, 7):
        out[f"drwtNo{i}"] = it[f"tm{i}WnNo"]
    return out


def get_lotto_number(drw_no):
    """특정 회차 결과를 예전 포맷으로 반환한다."""
    items = _get_list(
        f"{BASE}/selectPstLt645InfoNew.do",
        {"srchDir": "center", "srchLtEpsd": drw_no},
    )
    hit = next((it for it in items if it["ltEpsd"] == drw_no), None)
    return to_legacy(hit) if hit else {"returnValue": "fail"}


if __name__ == "__main__":
    print(get_lotto_number(1119))
get_lotto_number(1119)를 실행하면 기존 글의 예시 JSON과 같은 값이 나온다.
응답 목록에 해당 회차가 없으면(예: 아직 추첨 전) {"returnValue": "fail"}이 돌아온다.
전체 회차 일괄 수집
한 번 호출에 10개 회차가 오므로, 1회부터 최신 회차까지 약 125번 호출하면 전부 모인다. 예전처럼 회차마다 한 번씩 1,200번 넘게 호출할 필요가 없다.
위 예제의 _get_list, to_legacy와 아래 get_last_round를 함께 쓴다.
import json
import time


def collect_all(delay=1.0):
    last = get_last_round()
    rows = {}
    center = 1
    while len(rows) < last:
        items = _get_list(
            f"{BASE}/selectPstLt645InfoNew.do",
            {"srchDir": "center", "srchLtEpsd": center},
        )
        for it in items:
            rows[it["ltEpsd"]] = to_legacy(it)
        # 아직 없는 가장 작은 회차를 찾아, 그 회차가 앞쪽에 오도록 center 이동
        missing = next(n for n in range(1, last + 2) if n not in rows)
        if missing > last:
            break
        center = min(missing + 5, last)
        time.sleep(delay)  # 서버 부담을 줄이기 위한 간격
    return [rows[n] for n in sorted(rows) if n <= last]


if __name__ == "__main__":
    data = collect_all()
    with open("lotto645.json", "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)
    print(f"{len(data)}개 회차 저장 완료")
이미 저장한 파일이 있다면 마지막 회차 다음부터만 받도록 시작 center를 바꾸면 된다. 매주 한 번 돌리는 용도라면 최신 1건만 받아 추가하는 편이 가장 가볍다.
최신 회차 구하기
최신 회차는 이제 API로 바로 받는 것이 정확하다. 파라미터 없이 selectPstLt645Info.do를 호출하면 발표된 최신 회차 1건이 온다.
def get_last_round():
    """발표된 최신 회차 번호를 반환한다."""
    return _get_list(f"{BASE}/selectPstLt645Info.do")[0]["ltEpsd"]
기존 글의 날짜 계산 방식(2002-12-07 기준 주차 + 1)도 여전히 쓸 수 있다. 다만 토요일 추첨 전에는 아직 결과가 없는 회차 번호를 돌려준다는 한계가 있다. 네트워크 없이 대략적인 회차가 필요할 때만 보조로 쓰자.
주의사항
공식 공개 API가 아니므로 언제든 다시 바뀔 수 있다. 응답 형식이 달라지면 빨리 알아챌 수 있게 짜 두는 것이 좋다.
- 트래픽 제어: 동행복권 사이트에는 접속 대기와 IP 차단 화면이 있다. 이때는 JSON 대신 HTML이 오므로 Content-Type을 먼저 확인한다.
- 호출 간격: 연속 호출 시 0.5~1초 정도 쉬어 준다. 일괄 수집은 한 번만 돌리고 결과를 파일로 저장해 쓰자.
- 헤더: 테스트에서는 헤더 없이도 동작했다. User-Agent와 Referer는 차단 예방 차원에서 넣은 것이다.
- 조회 기간: 결과 페이지에는 "지급개시일로부터 1년 이내 조회" 문구가 있다. 하지만 API로는 2024년 1119회도 정상 조회됐다.
참고
- 동행복권 로또6/45 추첨결과
- selectPstLt645InfoNew.do 1119회 응답
- selectPstLt645Info.do 최신 회차 응답
- johyunchol/lottogo-python: 개편 대응 사례
- dusohn/Lottery PR #1: srchLtEpsd=all 사례
'Programming' 카테고리의 다른 글
| 대규모 멀티 Git 저장소 프로젝트의 구원투수: Git Repo 완벽 가이드 (vs 일반 Git 비교) (0) | 2026.10.23 |
|---|---|
| [로컬 AI] 내 PC에서 무료로 이미지를 생성하는 툴 추천 3선 (NVIDIA 그래픽카드 기준) (0) | 2026.10.22 |
| STM32 CubeIDE에 CMSIS-DSP arm_math.h 추가하기 (0) | 2025.04.04 |
| [ESP32] 커널 패닉 시, Backtrace 이용하기 (0) | 2025.03.12 |
| [C#] WPF ResourceDirectory를 통한 MVVM 구현 (0) | 2024.09.02 |

 beautify_bash.py