반응형

시놀로지 NAS(DSM)의 Docker에 Stash를 설치하고, 전용 Cloudflare WARP 프록시와 R18.dev PostgreSQL DB를 붙여 R18dev_SQL 스크레이퍼로 메타데이터를 가져오는 구성이다.

Claude를 통해 설치 절차를 도움받았고, 중간중간 트러블슈팅 과정도 함께 작성하였다.


* 본 문서의 Docker는 NAS(Synology) 환경에서 구동되고 있으며 Docker 디렉토리가 Volume2에 설치되어 있다.


1. 구성 개요

            stash-net (bridge)
 ┌─────────────────────────────────────────────┐
 │                                             │
 │  stash ──HTTP(S)──▶ stash-socks ──▶ 인터넷 │
 │    │                 (WARP)                 │
 │    └──psql──▶ r18-postgres                  │
 │                    ▲                        │
 │  r18-tools ────────┘ (덤프 갱신/스크레이퍼 설치, 1회성) │
 └─────────────────────────────────────────────┘


서비스 이미지 역할
stash-socks ghcr.io/mon-ius/docker-warp-socks:latest Stash 전용 WARP 프록시 (9091, HTTP/SOCKS5 겸용). 다른 용도의 warp-socks 컨테이너와 구분하기 위해 이름을 따로 씀
r18-postgres postgres:17-alpine R18.dev 덤프를 적재한 DB (r18)
stash stash-r18:latest (로컬 빌드) stashapp/stash:latest + py3-psycopg2, py3-pysocks
r18-tools postgres:17-alpine profiles: [tools] — up 으로는 안 뜨고 run 으로만 실행


파일 구조

/volume2/docker/stash/
├── docker-compose.yml
├── r18-update-cron.sh        # 작업 스케줄러용 정기 갱신 스크립트
├── stash/
│   └── Dockerfile            # Stash 이미지 확장
├── r18-tools/
│   └── r18.sh                # update / install-scraper
│
│   ── 아래는 실행 중 생성/사용되는 데이터 ──
├── config/                   # Stash 설정 (/root/.stash)
│   └── scrapers/R18dev_SQL/  # 스크레이퍼 설치 위치
├── metadata/  cache/  blobs/  generated/
├── r18-db/                   # PostgreSQL 데이터
├── r18-dumps/                # 받은 덤프 (r18-latest.sql.gz)
└── logs/                     # r18-update.log

미디어(e.g. aaa.mp4)는 /volume4/media → 컨테이너 /data (읽기 전용). 


2. 사전 준비

2-1. 권한

DSM에서는 일반 계정이 /var/run/docker.sock 에 접근할 수 없다. 모든 docker 명령은 sudo 로 실행한다.

permission denied while trying to connect to the Docker daemon socket

→ sudo 를 빼먹은 것.


2-2. 파일 배치

stash-r18.zip 을 /volume2/docker/stash/ 에 올리고 압축 해제. zip 안에 stash-r18/ 상위 폴더가 있으므로 내용물만 꺼낸다. (DSM에 unzip 이 없을 수 있어 7z 사용)

(7z사용이 어렵다면 winSCP와 같은 툴로 접근해서 ftp처럼 경로에 올리면 된다.)

cd /volume2/docker/stash
sudo 7z x stash-r18.zip -o/tmp/stash-r18 -y
sudo cp -r /tmp/stash-r18/stash-r18/. .
sudo rm -rf /tmp/stash-r18


docker-compose.yml, stash/Dockerfile, r18-tools/r18.sh, r18-update-cron.sh 가 모두 있는지 확인.


unable to prepare context: path "./stash" not found

→ stash/ 폴더(Dockerfile)를 빼먹은 것.


2-3. bind mount 폴더 생성

시놀로지 Docker는 없는 bind mount 경로를 자동 생성하지 않는다.

cd /volume2/docker/stash
sudo mkdir -p config/scrapers metadata cache blobs generated r18-db r18-dumps logs
Bind mount failed: '/volume2/docker/stash/r18-db' does not exist

→ 이 단계를 빼먹은 것.


2-4. 기존 stash 컨테이너가 있을 때

이름 충돌을 피하려면 기존 컨테이너가 어떻게 만들어졌는지 먼저 확인한다.

sudo docker inspect stash --format '{{ index .Config.Labels "com.docker.compose.project" }} / {{ index .Config.Labels "com.docker.compose.project.working_dir" }}'


결과 조치
stash / /volume2/docker/stash 같은 프로젝트. 그대로 up 하면 교체됨
비어 있음 / 다른 프로젝트 sudo docker stop stash && sudo docker rm stash 후 진행 (설정·DB는 bind mount라 유지됨). Container Manager의 다른 프로젝트였다면 그쪽도 정리

3. 설치

3-1. 기동

cd /volume2/docker/stash
sudo docker compose up -d --build --remove-orphans
sudo docker compose ps

stash-socks, r18-postgres 가 healthy 가 된 뒤 stash 가 뜬다. Stash UI: http://<NAS IP>:9999


WARP 동작 확인 (warp=on 이 보이면 정상):

sudo docker exec stash-socks curl -sx socks5h://127.0.0.1:9091 https://www.cloudflare.com/cdn-cgi/trace | grep warp


3-2. R18.dev DB 적재

덤프가 수 GB라 오래 걸린다. SSH가 끊겨도 계속되도록 스크립트로 실행하는 것을 권장.

cd /volume2/docker/stash
sudo -v                                   # 비밀번호 먼저 입력 (백그라운드에서 프롬프트에 막히지 않게)
sudo nohup bash r18-update-cron.sh >/dev/null 2>&1 &
tail -f logs/r18-update.log               # Ctrl+C 로 보기만 종료, 작업은 계속됨


정상 로그:

[r18] 덤프 확인: https://r18.dev/dumps/latest
[r18] 새 덤프 다운로드 완료 (x.xG)
[r18] 임시 DB(r18_new)에 적재 중…
[r18] r18 DB 교체
[r18] 완료 — derived_video N건


확인:

sudo docker exec r18-postgres psql -U postgres -d r18 -c "SELECT count(*) FROM derived_video;"

(2026-10 기준 약 191만 건)


3-3. 스크레이퍼 설치

sudo docker compose run --rm r18-tools install-scraper


install-scraper 가 하는 일:

  1. javstash/R18dev_SQL 저장소의 scrapers/R18dev_SQL/ 을 config/scrapers/R18dev_SQL/ 에 복사
  2. R18dev_SQL.py 수정
    • host="localhost" → host="r18-postgres"
    • password → R18_DB_PASSWORD (기본 postgres)
    • LANG='EN' (일본어: -e SCRAPER_LANG=JA 로 실행)
  3. 안전 실행 래퍼 R18dev_SQL_wrap.py 생성 + yml 이 래퍼를 호출하도록 수정
    • 원본은 결과가 없으면 아무것도 출력하지 않고 죽어서 Stash 가 could not unmarshal json from script output: EOF 를 냄
    • 래퍼는 이 경우 null / [] 을 출력해 '결과 없음' 으로 처리하고, 원인을 Stash 로그에 남김

설치 후 Stash: 설정 › Metadata Providers › Scrapers › Reload scrapers

스크레이퍼를 Stash UI(Available Scrapers)에서 다시 받으면 위 수정이 사라진다. 그럴 땐 install-scraper 를 다시 실행.

3-4. 스크레이퍼 동작 확인

sudo docker exec -i stash sh -c 'cd /root/.stash/scrapers/R18dev_SQL && echo "{\"code\":\"SSIS-001\"}" | python3 R18dev_SQL_wrap.py sceneByFragment' 2>/dev/null


"title": "After Abstaining ...", "performers": [{"name": "Donald Trump", ... 처럼 영문 JSON 이 나오면 정상.


4. 정기 덤프 갱신 (DSM 작업 스케줄러)

r18-update-cron.sh 동작:

  • 서버 덤프가 바뀌지 않았으면 다운로드·적재 없이 수 초 만에 종료 → 매일 실행 권장
  • r18_new 에 적재 → derived_video 검증 → 통과 시에만 r18 교체 (실패해도 기존 DB 유지)
  • flock 으로 중복 실행 방지, PATH 보정, docker compose run -T (TTY 없음)
  • 로그: logs/r18-update.log (최근 2000줄 유지)

등록

제어판 › 작업 스케줄러 › 생성 › 예약된 작업 › 사용자 정의 스크립트

탭 설정
일반 작업: R18 덤프 갱신 / 사용자: root
스케줄 매일, 04:00 등 한가한 시간
작업 설정 bash /volume2/docker/stash/r18-update-cron.sh
작업 설정 (선택) 실행 세부 정보 메일 → "비정상 종료 시에만"


등록 후 목록에서 선택 → 실행 으로 테스트.

강제 재적재:

cd /volume2/docker/stash
sudo FORCE=1 docker compose run --rm r18-tools update
교체 순간에는 덤프 + r18 +r18_new 가 동시에 존재하므로 /volume2 에 DB 크기 2배 이상 여유 공간이 필요하다.

5. Stash 에서 사용

5-1. 한 장면씩

장면 편집 › Scrape with… › JAVStash-R18dev_SQL. 파일명에 품번(ABCD-001 등)만 있으면 된다. 제목이 비어 있으면 Stash 가 파일명을 제목으로 넘긴다.

5-2. 일괄 수집·저장 (Identify)

Identify 는 위치가 두 군데이고 둘 다 숨겨져 있다.

위치 보이는 조건
설정 › Tasks › Library › Identify… 설정 화면 상단 Advanced Mode 를 켜야 보임. 전체 또는 경로 지정
Scenes 목록 › 우측 상단 ⋯ › Identify… 장면을 1개 이상 선택해야 보임

권장 옵션:

항목 설정
Sources JAVStash-R18dev_SQL 만 남김
Title / Details / Date / Code / Director Overwrite (기존 값 보존하려면 Ignore)
Performers / Tags Merge + Create missing
Studio Overwrite + Create missing
Set cover images 켬
Skip matches that have more than one result 켬
Set organised flag 필요 시

처음엔 장면 10개 정도로 시험 후 전체 실행.

결과를 눈으로 보며 저장하려면 Scenes 보기 방식을 Tagger 로 바꿔 소스를 R18dev_SQL 로 지정.


6. 문제 해결

증상 원인 / 조치
permission denied ... docker.sock sudo 누락
path "./stash" not found stash/Dockerfile 누락 → 2-2
Bind mount failed ... does not exist 폴더 미생성 → 2-3
could not unmarshal json from script output: EOF ① r18 DB 없음 → 3-2 ② 래퍼 미설치 → 3-3 다시 실행
database "r18" does not exist 덤프 적재 전이거나 실패 → logs/r18-update.log 확인 후 3-2
스크랩은 되는데 '결과 없음' Stash 로그(Debug)에서 확인: DB 에서 해당 작품을 찾지 못함 = R18.dev 에 없음 / 품번을 추출하지 못함 = 파일명·제목에 품번 없음
배우 이름이 일본어로 표시 아래 6-1


6-1. 배우 이름이 일본어로 나올 때

  1. 스크레이퍼 출력 확인 (3-4). 출력이 일본어면 LANG 이 JA → 수정:
   sudo sed -i "s/^LANG=.*/LANG='EN' # JA or EN/" config/scrapers/R18dev_SQL/R18dev_SQL.py


  1. 출력은 영문인데 Stash 에 일본어로 보이면 기존 배우와 매칭된 것. 예전에 LANG='JA' 로 스크랩하면 배우가 name=ドナルド・トランプ, aliases=Donald Trump로 생성되므로, 영문 이름이 별칭으로 매칭되어 일본어 이름이 표시된다. → Performers 에서 Name 을 영문으로, 일본어 이름을 Aliases 로 옮긴다.
  2. DB 에 영문 이름 자체가 없는지 확인:
   sudo docker exec r18-postgres psql -U postgres -d r18 -c "
   SELECT A.id, A.name_kanji, A.name_romaji, MT.target_en
   FROM derived_video_actress VA
   LEFT JOIN derived_actress A ON VA.actress_id = A.id
   LEFT JOIN machine_translation MT ON A.name_kanji = MT.source_ja
   WHERE VA.content_id = 'ssis00001';"

name_romaji, target_en 둘 다 비어 있으면 R18.dev 데이터에 영문명이 없는 것 (스크레이퍼는 일본어로 대체).


7. 유지보수

작업 명령
Stash 업데이트 sudo docker compose build --pull stash && sudo docker compose up -d (커스텀 이미지라 pull 만으로는 안 됨)
프록시·DB 이미지 업데이트 sudo docker compose pull stash-socks r18-postgres && sudo docker compose up -d
스크레이퍼 재설치 sudo docker compose run --rm r18-tools install-scraper
덤프 갱신 로그 tail -n 50 /volume2/docker/stash/logs/r18-update.log
전체 상태 sudo docker compose ps
컨테이너 로그 sudo docker compose logs -f stash


설정 메모

  • 프록시는 http://stash-socks:9091 로 지정 (warp-socks v8 은 같은 포트에서 HTTP 도 받음). socks5h:// 로 쓰면 파이썬 requests 에 PySocks 가 필요 — 이미지에 py3-pysocks 를 넣어 두었으므로 바꿔도 동작은 함.
  • NO_PROXY 에 내부 컨테이너와 사설 대역이 들어 있어 DB·LAN 통신은 프록시를 타지 않음.
  • 다른 기기에서 이 프록시를 쓰려면 stash-socks 의 ports 주석을 해제 (9092:9091, 기존 warp-socks 의 9091 과 겹치지 않게).
  • DB 비밀번호를 바꾸려면 docker-compose.yml 옆에 .env 를 만들고 R18_DB_PASSWORD=... 지정. DB 최초 생성 전에 정해야 하며, 바꾼 뒤 install-scraper 재실행.

참고

더보기

docker-compose.yml:

# Stash + Cloudflare WARP 프록시 + R18.dev PostgreSQL
# 배치 위치 예: /volume2/docker/stash/  (이 파일, stash/, r18-tools/ 를 같은 폴더에)
#
#   최초 기동 :  docker compose up -d --build
#   DB 덤프   :  docker compose run --rm r18-tools update
#   스크레이퍼:  docker compose run --rm r18-tools install-scraper

x-proxy-env: &proxy-env
  # warp-socks v8 은 9091 한 포트에서 HTTP/SOCKS5 를 같이 제공.
  # http:// 로 지정해야 스크레이퍼(파이썬 requests)도 별도 의존성 없이 프록시를 탄다.
  HTTP_PROXY: http://stash-socks:9091
  HTTPS_PROXY: http://stash-socks:9091
  http_proxy: http://stash-socks:9091
  https_proxy: http://stash-socks:9091
  NO_PROXY: &no-proxy localhost,127.0.0.1,stash-socks,r18-postgres,192.168.0.0/16,10.0.0.0/8,172.16.0.0/12
  no_proxy: *no-proxy

services:
  stash-socks:
    image: ghcr.io/mon-ius/docker-warp-socks:latest
    container_name: stash-socks
    restart: unless-stopped
    # 다른 기기에서도 이 프록시를 쓰려면 아래 주석 해제 (호스트 포트가 다른 warp-socks 컨테이너와 겹치지 않게 조정)
    # ports:
    #   - "9092:9091"   # 기존 warp-socks(9091)와 겹치지 않게
    healthcheck:
      test: ["CMD", "curl", "-x", "socks5h://127.0.0.1:9091", "-fsSL", "https://www.cloudflare.com/cdn-cgi/trace"]
      interval: 30s
      timeout: 10s
      retries: 5
      start_period: 15s
    networks:
      - stash-net

  r18-postgres:
    image: postgres:17-alpine
    container_name: r18-postgres
    restart: unless-stopped
    shm_size: 256mb            # 덤프 import 중 인덱스 생성 시 shared memory 부족 방지
    environment:
      TZ: Asia/Seoul
      POSTGRES_USER: postgres
      POSTGRES_PASSWORD: ${R18_DB_PASSWORD:-postgres}
      POSTGRES_DB: postgres
    volumes:
      - /volume2/docker/stash/r18-db:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres"]
      interval: 10s
      timeout: 5s
      retries: 10
    networks:
      - stash-net

  stash:
    build: ./stash                 # stashapp/stash:latest + psycopg2/pysocks
    image: stash-r18:latest
    container_name: stash
    restart: unless-stopped
    ports:
      - "9999:9999"
    environment:
      <<: *proxy-env
      TZ: Asia/Seoul
      STASH_STASH: /data
      STASH_GENERATED: /generated
      STASH_METADATA: /metadata
      STASH_CACHE: /cache
      STASH_BLOBS: /blobs
    volumes:
      - /volume2/docker/stash/config:/root/.stash
      - /volume2/docker/stash/metadata:/metadata
      - /volume2/docker/stash/cache:/cache
      - /volume2/docker/stash/blobs:/blobs
      - /volume2/docker/stash/generated:/generated
      - /volume2/MEDIA:/data:ro
    depends_on:
      stash-socks:
        condition: service_healthy
      r18-postgres:
        condition: service_healthy
    networks:
      - stash-net

  # 1회성 작업용 (up 으로는 뜨지 않음): docker compose run --rm r18-tools <update|install-scraper>
  r18-tools:
    image: postgres:17-alpine
    profiles: ["tools"]
    entrypoint: ["sh", "/r18.sh"]
    command: ["update"]
    environment:
      <<: *proxy-env
      PGHOST: r18-postgres
      PGUSER: postgres
      PGPASSWORD: ${R18_DB_PASSWORD:-postgres}
      FORCE: ${FORCE:-0}
    volumes:
      - ./r18-tools/r18.sh:/r18.sh:ro
      - /volume2/docker/stash/r18-dumps:/dumps
      - /volume2/docker/stash/config/scrapers:/scrapers
    depends_on:
      stash-socks:
        condition: service_healthy
      r18-postgres:
        condition: service_healthy
    networks:
      - stash-net

networks:
  stash-net:
    driver: bridge
반응형

수십, 수백 개의 독립된 Git 저장소로 이루어진 대규모 프로젝트(예: 안드로이드 오픈소스 프로젝트 - AOSP)를 관리해 본 적이 있다면? 각 서비스나 모듈이 개별 저장소로 분리되어 있을 때, 일반적인 Git 명령어만으로는 전체 코드베이스의 일관성을 유지하고 협업하는 것이 매우 번거롭고 복잡해진다.

이번 글에서는 구글(Google)이 개발한 멀티 저장소 관리 도구인 Repo의 개념과 일반 Git과의 차이점, 그리고 실제 프로젝트에 적용하는 Manifest 설정 방법까지 완벽하게 정리해 본다.

1. Git만으로는 부족한 순간: 멀티 Repo 관리의 어려움

현대 대규모 소프트웨어 아키텍처는 코드베이스를 여러 개의 독립된 Git 저장소로 쪼개어 관리하는 경우가 많다. 이때 Git의 기본 기능(Submodule, Subtree 등)을 활용할 수 있지만, 다음과 같은 한계에 부딪히게 된다.

  • 동기화의 어려움: 수십 개의 저장소에서 각각 특정 브랜치나 커밋을 일일이 git pull하고 상태를 확인하는 작업은 피로감을 준다.
  • 원자적(Atomic) 작업의 부재: 여러 저장소에 걸쳐 코드를 수정하고 동시에 브랜치를 생성하거나 커밋/푸시를 수행할 때 휴먼 에러가 발생하기 쉽다.
  • 버전 관리의 파편화: 어떤 조합의 커밋들이 정상적으로 빌드되는 버전인지(Manifest) 전체적인 스냅샷을 관리하기 어렵다.

이러한 문제를 해결하기 위해 등장한 것이 바로 Repo다.

2. Google Repo란 무엇인가?

Repo는 Git을 대체하는 도구가 아니라, 여러 개의 Git 저장소를 상위 레벨에서 통합 관리하기 위해 구글이 만든 파이썬 기반의 툴이다.

Repo는 Manifest(매니페스트) 파일을 기반으로 작동한다. Manifest 파일은 XML 형식으로 작성되며, 프로젝트 내에 어떤 Git 저장소들이 포함되어 있고 각각 어떤 브랜치나 리비전(Revision)을 바라봐야 하는지를 정의한다.

핵심 동작 방식

  1. repo init: 프로젝트의 기준이 되는 Manifest 저장소를 클론하고 작업 디렉터리를 초기화한다.
  2. repo sync: Manifest 파일에 명시된 모든 하위 Git 저장소를 한 번에 클론하거나 최신 상태로 동기화한다.

3. Git vs Repo 핵심 비교

구분 Git (단일 저장소) Repo (멀티 저장소 관리자)
관리 단위 단일 Git 저장소 (Repository) 수십~수백 개의 Git 저장소 집합
핵심 목적 개별 소스코드의 버전 관리 및 이력 추적 여러 저장소 간의 버전 동기화 및 협업 워크플로우 조율
설정 관리 .git 디렉터리 및 .gitmodules XML 기반의 Manifest 파일
주요 작업 방식 git clone, git pull, git push 등 개별 실행 repo sync, repo start, repo upload 등 일괄 처리
대상 프로젝트 단일 애플리케이션, 라이브러리 등 안드로이드 OS, 대규모 임베디드 시스템, 마이크로서비스 아키텍처 등

4. Repo의 핵심: Manifest 파일 (default.xml) 예제

Repo를 작동시키기 위해 가장 중요한 것은 저장소 구조를 정의하는 Manifest 파일이다.

Manifest 기본 구조 예제

<?xml version="1.0" encoding="UTF-8"?>
<manifest>

  <!-- 1. 원격 저장소 서버(Remote) 정의 -->
  <remote name="origin"
          fetch="https://github.com/my-organization"
          review="https://review.my-organization.com" />

  <!-- 2. 기본값(Default) 설정 -->
  <default revision="main"
           remote="origin"
           sync-j="4" />

  <!-- 3. 개별 Git 저장소(Project) 목록 정의 -->
  <!-- 메인 프레임워크 저장소 -->
  <project path="src/framework" name="core-framework.git" revision="release/v1.0" />

  <!-- 모듈/라이브러리 저장소 -->
  <project path="src/modules/auth" name="module-auth.git" />
  <project path="src/modules/payment" name="module-payment.git" />

  <!-- 외부 오픈소스 라이브러리 (다른 원격 서버 사용 예시) -->
  <remote name="external-git" fetch="https://github.com/external-lib" />
  <project path="src/vendor/libfoo" name="libfoo.git" remote="external-git" revision="v2.1.0" />

</manifest>

Manifest 주요 태그 설명

  • <remote>: Git 서버의 Base URL(fetch)을 정의한다.
  • <default>: <project> 태그에서 별도 지정이 없을 때 사용할 기본 브랜치(revision)와 서버(remote)를 지정한다.
  • <project>: 실제 로컬로 가져올 개별 Git 저장소를 정의한다. path는 로컬 폴더 경로, name은 서버의 저장소 이름이다.

TIP: 프로젝트 규모가 너무 커지면 <include name="other_manifest.xml"/> 태그를 활용해 Manifest 파일 자체를 여러 개로 분할해 관리할 수도 있다.

5. 실무에서 주로 사용하는 Repo 명령어 워크플로우

  1. Manifest 저장소 초기화
    repo init -u https://github.com/my-org/manifests.git -b main
  2. 전체 저장소 일괄 동기화 (다운로드)
    repo sync
  3. 전체 저장소 동시 브랜치 생성
    repo start feature/new-login --all
  4. 전체 작업 상태 확인
    repo status

6. 결론: 어떤 프로젝트에 도입해야 할까?

  • 일반 Git이 적합한 경우: 하나의 저장소에서 개발이 이루어지거나, Git Submodule만으로도 충분히 관리가 가능한 중소규모 프로젝트.
  • Repo가 적합한 경우: 수십 개 이상의 독립된 저장소가 유기적으로 엮여 있어 전체 코드베이스의 일괄 동기화와 스냅샷 관리가 필수적인 대규모 프로젝트.

프로젝트의 규모가 커져서 여러 Git 저장소를 유기적으로 묶어 관리해야 하는 골칫거리가 생겼다면, Repo 도입을 진지하게 고려해 볼 만하다. 개발 생산성을 극적으로 끌어올려 줄 것이다.

반응형

업데이트 안내

2026년 동행복권 사이트 개편으로 기존 회차 조회 URL은 더 이상 JSON을 주지 않는다. 대신 /lt645/ 경로 아래의 새 JSON API를 쓰면 된다.

기존 URL https://www.dhlottery.co.kr/common.do?method=getLottoNumber&drwNo=1119를 호출하면 이제 동행복권 메인 페이지(HTML)로 리다이렉트된다. 그래서 기존 코드는 json.loads 단계에서 실패한다.

이 글은 새 API 주소, 바뀐 필드명, 기존 코드를 거의 그대로 살리는 호환 래퍼를 정리한 것이다. 아래 내용은 2026년 10월 기준으로 직접 호출해 확인했다.

새 엔드포인트

특정 회차는 selectPstLt645InfoNew.do, 최신 회차는 selectPstLt645Info.do로 가져온다. 둘 다 별도 인증 없이 application/json을 반환한다.

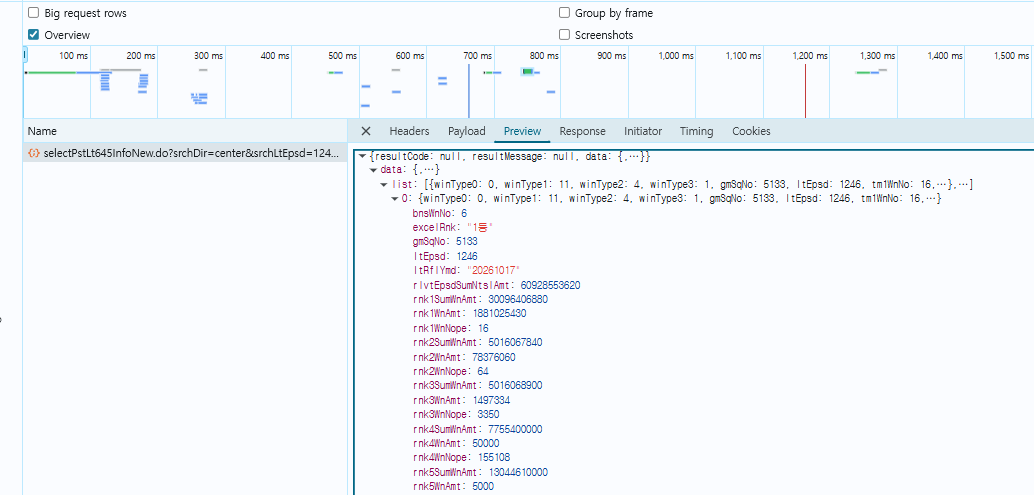
찾는 방법은 예전과 같다. 크롬 개발자도구(F12)의 Network 탭을 연다. 그 상태로 로또6/45 추첨결과 페이지에서 회차를 바꿔 보면, Fetch/XHR 목록에 아래 요청이 보인다.

용도 URL 비고
특정 회차 https://www.dhlottery.co.kr/lt645/selectPstLt645InfoNew.do?srchDir=center&srchLtEpsd=1119 지정 회차를 중심으로 10개 회차를 반환 (1119 → 1114~1123)
최신 회차 1건 https://www.dhlottery.co.kr/lt645/selectPstLt645Info.do 파라미터 없이 최신 회차 1건 반환
메인 요약 https://www.dhlottery.co.kr/selectMainInfo.do data.result.pstLtEpstInfo.lt645에 최근 5회. 순서가 섞여 있어 정렬 필요


srchLtEpsd가 회차 번호다. 예전 drwNo와 같은 역할이다.

selectPstLt645Info.do?srchLtEpsd=1119처럼 회차를 줘도 최신 회차만 돌아온다. 따라서 특정 회차는 InfoNew로 받아서 원하는 회차만 골라내야 한다.

참고로 selectPstLt645Info.do?srchLtEpsd=all로 전 회차를 받은 사례도 있다. 직접 검증하지는 못했으니 참고만 하자.


응답 JSON

응답은 data.list 배열에 회차별 객체가 들어 있는 구조다. 아래는 1119회 항목만 뽑아 주석을 단 것이다. 기존 글의 1119회 값과 정확히 일치한다.

{
   "resultCode": null,
   "resultMessage": null,
   "data": {
      "list": [
         {
            "ltEpsd": 1119,                    // 회차
            "ltRflYmd": "20240511",            // 추첨일 (YYYYMMDD)
            "tm1WnNo": 1,                      // 1번째 번호
            "tm2WnNo": 9,                      // 2번째 번호
            "tm3WnNo": 12,                     // 3번째 번호
            "tm4WnNo": 13,                     // 4번째 번호
            "tm5WnNo": 20,                     // 5번째 번호
            "tm6WnNo": 45,                     // 6번째 번호
            "bnsWnNo": 3,                      // 보너스 번호
            "rnk1WnNope": 19,                  // 1등 당첨자 수
            "rnk1WnAmt": 1396028764,           // 1등 1인당 당첨금
            "rnk1SumWnAmt": 26524546516,       // 1등 총 당첨금
            "rnk2WnNope": 97,                  // 2등 당첨자 수 (rnk2~5 동일 패턴)
            "rnk2WnAmt": 45574823,             // 2등 1인당 당첨금
            "rnk2SumWnAmt": 4420757831,        // 2등 총 당첨금
            "rnk3WnNope": 3108,
            "rnk3WnAmt": 1422381,
            "rnk3SumWnAmt": 4420760148,
            "rnk4WnNope": 155000,
            "rnk4WnAmt": 50000,
            "rnk4SumWnAmt": 7750000000,
            "rnk5WnNope": 2560859,
            "rnk5WnAmt": 5000,
            "rnk5SumWnAmt": 12804295000,
            "sumWnNope": 2719083,             // 1~5등 전체 당첨자 수
            "wholEpsdSumNtslAmt": 111840714000,// 총판매금액
            "rlvtEpsdSumNtslAmt": 55920357000, // 의미 미확인 (총판매금액의 약 절반)
            "winType1": 15,                    // 1등 자동 당첨 수
            "winType2": 4,                     // 1등 수동 당첨 수
            "winType3": 0,                     // 1등 반자동 당첨 수
            "winType0": 0,
            "gmSqNo": 5133,
            "excelRnk": "1등"
         }
         // ... 1114 ~ 1123회 항목이 함께 온다
      ]
   }
}

winType1~3은 결과 페이지의 "1등 자동/수동/반자동" 숫자와 일치한다. 1246회 기준 11/4/1이었다. winType0, gmSqNo, excelRnk는 의미를 확인하지 못했다.


기존 필드와 새 필드 비교

필드 이름은 모두 바뀌었다. 하지만 1:1로 대응되므로 매핑만 바꾸면 된다. 추첨일 형식과 성공 여부 판단 방식은 주의해야 한다.

기존 필드 새 필드 설명
drwNo ltEpsd 회차
drwNoDate (2024-05-11) ltRflYmd (20240511) 추첨일. 구분자 없는 형식으로 바뀜
drwtNo1 ~ drwtNo6 tm1WnNo ~ tm6WnNo 당첨번호 6개
bnusNo bnsWnNo 보너스 번호
firstWinamnt rnk1WnAmt 1등 1인당 당첨금
firstPrzwnerCo rnk1WnNope 1등 당첨자 수
firstAccumamnt rnk1SumWnAmt 1등 총 당첨금
totSellamnt wholEpsdSumNtslAmt 총판매금액
returnValue 없음 list에 해당 ltEpsd가 있는지로 판단
없음 rnk2~5WnNope / WnAmt / SumWnAmt 2~5등 당첨자 수와 금액 (신규)
없음 winType1~3 1등 자동/수동/반자동 수 (신규)

정정: 기존 글에서 totSellamnt를 "전체 당첨 상금 총액"이라고 설명했는데, 이는 잘못이다. 실제로는 총판매금액이다. 결과 페이지의 1246회 총판매금액 121,857,105,000원이 wholEpsdSumNtslAmt 값과 같다.


파이썬 예제: 기존 포맷 호환 래퍼

새 응답을 예전 키 이름으로 바꿔 주는 함수를 두면, 기존 코드는 호출 함수만 교체하면 된다. 반환값은 예전 getLottoNumber 응답과 같은 모양이다.


import requests

BASE = "https://www.dhlottery.co.kr/lt645"
HEADERS = {
    "User-Agent": "Mozilla/5.0",
    "Referer": "https://www.dhlottery.co.kr/lt645/result",
}


def _get_list(url, params=None):
    """API를 호출해 data.list 를 반환한다."""
    r = requests.get(url, params=params, headers=HEADERS, timeout=10)
    r.raise_for_status()
    # 차단/대기 시에는 HTML 페이지가 오므로 Content-Type 을 먼저 확인
    if "application/json" not in r.headers.get("Content-Type", ""):
        raise RuntimeError("JSON이 아닌 응답 (접속 대기/차단 페이지 가능성)")
    return r.json()["data"]["list"]


def to_legacy(it):
    """새 응답 항목을 예전 getLottoNumber 포맷으로 변환한다."""
    d = it["ltRflYmd"]  # "20240511"
    out = {
        "returnValue": "success",
        "drwNo": it["ltEpsd"],
        "drwNoDate": f"{d[:4]}-{d[4:6]}-{d[6:]}",
        "bnusNo": it["bnsWnNo"],
        "firstWinamnt": it["rnk1WnAmt"],
        "firstPrzwnerCo": it["rnk1WnNope"],
        "firstAccumamnt": it["rnk1SumWnAmt"],
        "totSellamnt": it["wholEpsdSumNtslAmt"],
    }
    for i in range(1, 7):
        out[f"drwtNo{i}"] = it[f"tm{i}WnNo"]
    return out


def get_lotto_number(drw_no):
    """특정 회차 결과를 예전 포맷으로 반환한다."""
    items = _get_list(
        f"{BASE}/selectPstLt645InfoNew.do",
        {"srchDir": "center", "srchLtEpsd": drw_no},
    )
    hit = next((it for it in items if it["ltEpsd"] == drw_no), None)
    return to_legacy(hit) if hit else {"returnValue": "fail"}


if __name__ == "__main__":
    print(get_lotto_number(1119))

get_lotto_number(1119)를 실행하면 기존 글의 예시 JSON과 같은 값이 나온다.

응답 목록에 해당 회차가 없으면(예: 아직 추첨 전) {"returnValue": "fail"}이 돌아온다.


전체 회차 일괄 수집

한 번 호출에 10개 회차가 오므로, 1회부터 최신 회차까지 약 125번 호출하면 전부 모인다. 예전처럼 회차마다 한 번씩 1,200번 넘게 호출할 필요가 없다.

위 예제의 _get_list, to_legacy와 아래 get_last_round를 함께 쓴다.

import json
import time


def collect_all(delay=1.0):
    last = get_last_round()
    rows = {}
    center = 1
    while len(rows) < last:
        items = _get_list(
            f"{BASE}/selectPstLt645InfoNew.do",
            {"srchDir": "center", "srchLtEpsd": center},
        )
        for it in items:
            rows[it["ltEpsd"]] = to_legacy(it)
        # 아직 없는 가장 작은 회차를 찾아, 그 회차가 앞쪽에 오도록 center 이동
        missing = next(n for n in range(1, last + 2) if n not in rows)
        if missing > last:
            break
        center = min(missing + 5, last)
        time.sleep(delay)  # 서버 부담을 줄이기 위한 간격
    return [rows[n] for n in sorted(rows) if n <= last]


if __name__ == "__main__":
    data = collect_all()
    with open("lotto645.json", "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)
    print(f"{len(data)}개 회차 저장 완료")


이미 저장한 파일이 있다면 마지막 회차 다음부터만 받도록 시작 center를 바꾸면 된다. 매주 한 번 돌리는 용도라면 최신 1건만 받아 추가하는 편이 가장 가볍다.


최신 회차 구하기

최신 회차는 이제 API로 바로 받는 것이 정확하다. 파라미터 없이 selectPstLt645Info.do를 호출하면 발표된 최신 회차 1건이 온다.

def get_last_round():
    """발표된 최신 회차 번호를 반환한다."""
    return _get_list(f"{BASE}/selectPstLt645Info.do")[0]["ltEpsd"]

기존 글의 날짜 계산 방식(2002-12-07 기준 주차 + 1)도 여전히 쓸 수 있다. 다만 토요일 추첨 전에는 아직 결과가 없는 회차 번호를 돌려준다는 한계가 있다. 네트워크 없이 대략적인 회차가 필요할 때만 보조로 쓰자.


주의사항

공식 공개 API가 아니므로 언제든 다시 바뀔 수 있다. 응답 형식이 달라지면 빨리 알아챌 수 있게 짜 두는 것이 좋다.

  • 트래픽 제어: 동행복권 사이트에는 접속 대기와 IP 차단 화면이 있다. 이때는 JSON 대신 HTML이 오므로 Content-Type을 먼저 확인한다.
  • 호출 간격: 연속 호출 시 0.5~1초 정도 쉬어 준다. 일괄 수집은 한 번만 돌리고 결과를 파일로 저장해 쓰자.
  • 헤더: 테스트에서는 헤더 없이도 동작했다. User-Agent와 Referer는 차단 예방 차원에서 넣은 것이다.
  • 조회 기간: 결과 페이지에는 "지급개시일로부터 1년 이내 조회" 문구가 있다. 하지만 API로는 2024년 1119회도 정상 조회됐다.

참고

반응형

온라인 AI 서비스의 사용량 제한이나 유료 구독 비용이 부담스러우셨나요?NVIDIA 그래픽카드가 탑재된 데스크탑이 있다면, 내 컴퓨터에 직접 툴을 설치해서 인터넷 연결 없이 무제한으로 고품질 이미지를 생성할 수 있다.

오늘은 사용 목적과 난이도에 따라 선택하기 좋은 대표적인 로컬 이미지 생성 툴 3가지를 시도해보려고 작성해본다.


1. Fooocus (가장 쉽고 빠른 툴 – 초보자 강력 추천)

"미드저니(Midjourney)처럼 복잡한 설정 없이 프롬프트만으로 고품질 이미지를 뽑고 싶다면?"

  • 특징: Stable Diffusion XL(SDXL) 기반으로 작동하며, 원클릭 인스톨러를 제공해 설치가 매우 간단합니다.
  • 장점:
    • 복잡한 파라미터(옵션) 설정 없이 텍스트 입력만으로 고품질 결과물이 나옵니다.
    • 스타일 체크박스(사진 스타일, 애니메이션, 아트 등)를 클릭해 원하는 느낌을 쉽게 적용할 수 있습니다.
  • 단점: 세밀한 파이프라인 제어나 고급 노드 기반 수정에는 한계가 있습니다.
  • 추천 대상: AI 이미지 생성을 처음 접하거나, 머리 아픈 설정 없이 예쁜 이미지를 바로 뽑고 싶은 분.

2. Stable Diffusion WebUI (AUTOMATIC1111) (가장 대중적인 툴)

"가장 정보가 많고 직관적인 웹 인터페이스를 원한다면?"

  • 특징: 오랫동안 로컬 AI 생성 분야에서 가장 널리 쓰여온 대중적인 웹 GUI 툴입니다.
  • 장점:
    • 인터넷에 튜토리얼, 사용자 가이드, 설정 팁 등 참고할 레퍼런스가 가장 많습니다.
    • 무수히 많은 확장 프로그램(Extension)을 통해 필요한 기능을 추가할 수 있습니다.
  • 단점: 최신 모델(Flux 등) 적용 시 설정이 조금 까다롭거나 메모리 관리 측면에서 아주 효율적이지는 않습니다.
  • 추천 대상: 직관적인 인터페이스에서 다양한 체크포인트 모델과 플러그인을 활용해 보고 싶은 분.

3. ComfyUI (전문가용 최강 성능 & 유연성)

"VRAM 효율 극대화, 나만의 정밀한 생성 파이프라인을 구축하고 싶다면?"

  • 특징: 노드(Node)를 연결하여 이미지 생성 흐름을 직접 조립하는 전문적인 툴입니다.
  • 장점:
    • 메모리(VRAM) 최적화가 훌륭해 낮은 그래픽카드 사양에서도 원활하게 작동합니다.
    • SDXL, Stable Diffusion 3, Flux 등 최신 모델을 가장 빠르고 완벽하게 지원합니다.
    • 업스케일링, 인페인팅, ControlNet 등 복잡한 작업을 하나의 워크플로우로 자동화할 수 있습니다.
  • 단점: 노드 연결 방식이 생소해 초기 진입 장벽이 다소 높은 편입니다.
  • 추천 대상: 그래픽카드 성능을 100% 활용하고 싶거나, 정밀한 이미지 제어가 필요한 고수분들.

💡 요약 및 선택 가이드

툴 이름 난이도 주요 장점 추천 대상
Fooocus 초급 간단한 설치, 미드저니 스타일의 결과물 입문자, 빠른 결과물을 원하는 분
WebUI (A1111) 중급 풍부한 레퍼런스, 다양한 확장 기능 대중적이고 직관적인 환경을 선호하는 분
ComfyUI 고급 뛰어난 VRAM 효율, 정밀한 워크플로우 제어 최신 모델 및 고성능 자동화를 원하는 분
반응형

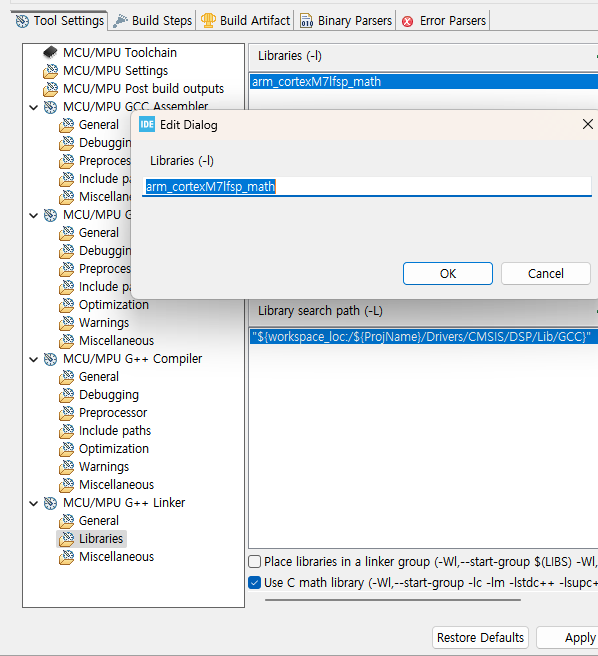
관련 내용은 아래 링크에 상세 설명되어있다.

https://community.st.com/t5/stm32-mcus/how-to-add-external-libraries-in-stm32cubeide/ta-p/628619


How to add external libraries in STM32CubeIDE

Summary This article shows how to integrate a library, in the form of an achieve file (*.a) in your project, so you can use the functions of the library with a simple header file.  Introduction A library can be defined as a set of nonvolatile resources th

community.st.com


다만, 한가지 유의할 점은 사용하고자 하는 MCU의 아키텍처에 맞는 *.a 파일을 라이브러리 항목에 추가할때


보통 파일명이 lib라이브러리파일이름.a 인데( 확장자가 *.a)

맨앞 lib 떼고, 확장자 뗀 이름만 넣어야한다.


반응형

ESP32 보드에서 작업을 하던 중 커널 패닉이 발생하여 디버깅을 해야한다.


개발보드가 아니고 ESP32 SoC가 PCB에 온보드된 상태라서 JTAG같은 디버깅을 사용할 수 없다.


backtrace를 활성화하면 커널패닉등으로 Falut가 발생하면 콜스택 위치를 뿌려준다.

물론 친절하게 어느 파일 몇번째 라인 이렇게 안뿌려준다.


아래 명령으로 해당 빌드 이미지와 함께 사용하면 된다.

xtensa-esp32-elf-addr2line -pfiaC -e build/PROJECT.elf backtace 주소


+ Recent posts